GEO
Anatomie d’une réponse générative : comment les LLM synthétisent leurs sources

Quand un grand modèle de langage répond à une question, il ne consulte pas des sources comme un chercheur parcourant une bibliothèque : il prédit, token après token, une séquence statistiquement vraisemblable à partir des éléments présents dans son contexte. Cette mécanique, fondamentalement différente d’une synthèse analytique, soulève des questions cruciales pour toute organisation qui déploie ces systèmes en production. Comment un LLM sélectionne-t-il réellement ses sources, comment les arbitre-t-il lorsqu’elles se contredisent, et qui porte la responsabilité lorsque la réponse générée s’avère factuellement inexacte ?
La situation initiale : Air Canada et la promesse d’un remboursement fantôme
Le 11 novembre 2022, Jake Moffatt se connecte au site d’Air Canada avec une question précise : peut-il bénéficier d’un tarif de deuil pour un vol Vancouver-Toronto, suite au décès de sa grand-mère ? Le chatbot de la compagnie lui répond. La réponse est nette, structurée, rassurante. Il peut acheter son billet au tarif normal, puis soumettre une demande de remboursement rétroactif dans un délai de 90 jours suivant l’émission du billet, via un formulaire en ligne dédié. Le bot ajoute un détail décisif : les mots « tarifs de deuil » sont présentés comme un lien hypertexte ancré, redirigeant directement vers la page officielle de la politique d’Air Canada.
C’est ici que le mécanisme de confiance se referme. Moffatt ne lit pas un résumé approximatif produit par une machine. Il lit ce qui ressemble à une synthèse sourcée, adossée à la documentation officielle de la compagnie. Le lien hypertexte joue le rôle d’une ancre d’autorité : il signale que la réponse générée n’est pas une improvisation, mais une interprétation fidèle d’une source vérifiable. Pour un utilisateur ordinaire, cette combinaison, texte explicatif plus renvoi vers la politique officielle, constitue exactement le standard de fiabilité attendu d’un service client institutionnel.
Ce que Moffatt ne perçoit pas, parce que rien dans la forme de la réponse ne l’y invite, c’est que le texte généré contredit directement la page vers laquelle pointe ce lien. La politique officielle d’Air Canada interdisait explicitement les remboursements post-voyage. Le LLM avait produit une synthèse inexacte, puis l’avait habillée d’une référence officielle qui infirmait son propre contenu.
La présence d’un lien hypertexte officiel dans une réponse générée ne garantit pas que le contenu de cette réponse reflète le document lié.
Moffatt achète son billet. Il soumet ensuite sa demande de remboursement dans les délais indiqués par le chatbot. Air Canada refuse. La compagnie fait valoir que le chatbot constitue une « entité légale distincte, responsable de ses propres actions », et que l’utilisateur aurait dû lire le texte de la page liée plutôt que de se fier à la synthèse. Le 14 février 2024, le Tribunal de règlement civil de la Colombie-Britannique tranche dans l’affaire Moffatt v. Air Canada (2024 BCCRT 149) : Air Canada est condamnée pour fausse déclaration négligente et doit verser 812,02 $ CAD en dommages, intérêts et frais. Le cas devient une référence documentée sur les effets concrets d’une hallucination de LLM en contexte opérationnel.
Ce qui s’est vraiment passé dans le moteur : l’anatomie de la synthèse défaillante
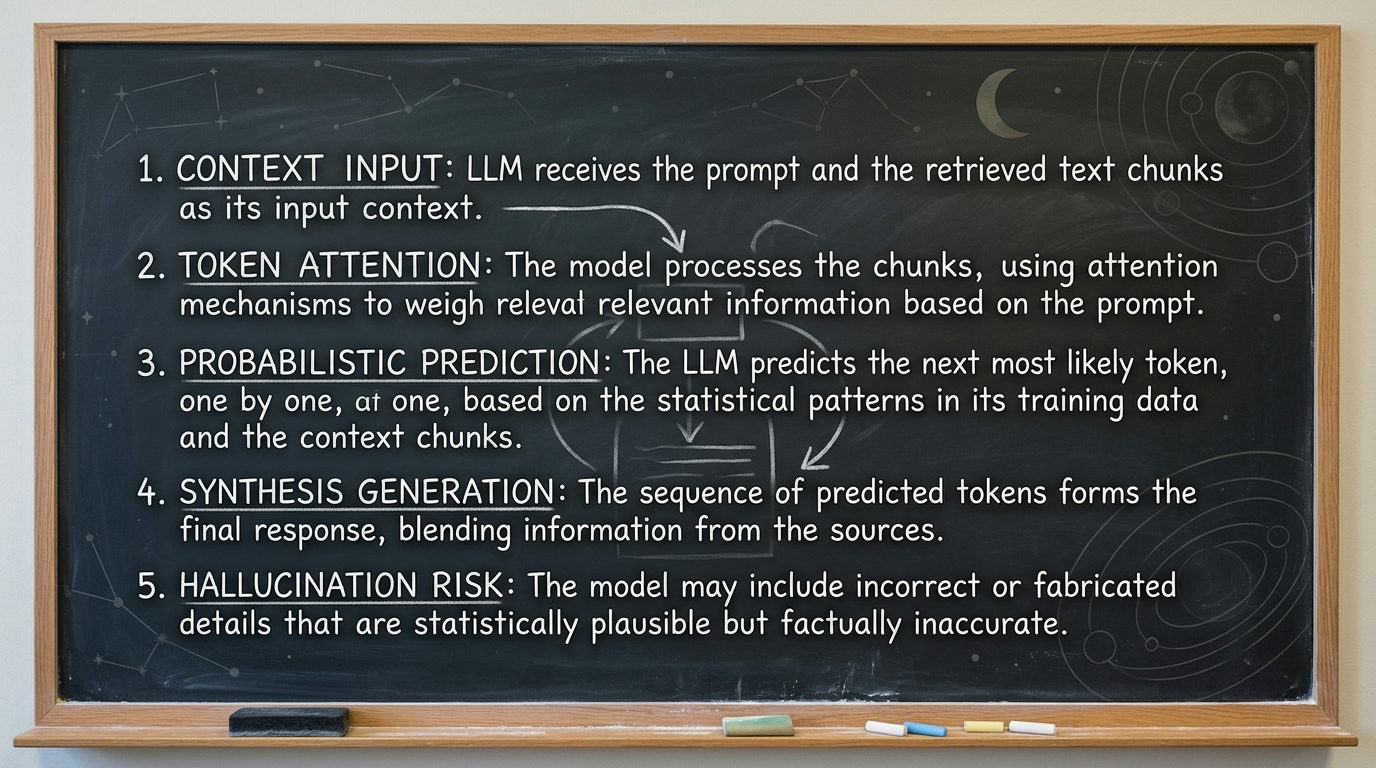
Commençons par dissiper une idée reçue fondamentale. Lorsqu’un système RAG alimente un LLM avec plusieurs chunks issus de la documentation d’une marque, il ne procède à aucune fusion sémantique. Il place ces fragments bruts, bout à bout, dans la fenêtre de contexte du modèle. Ce que le modèle fait ensuite n’a rien d’une synthèse au sens analytique du terme : il prédit le token suivant, puis le token suivant encore, de manière purement séquentielle, sans jamais embrasser l’ensemble du contenu injecté avec une vision globale. C’est la première mécanique à intégrer pour comprendre la défaillance.
Vient ensuite la contrainte architecturale. Au cœur de chaque Transformer se trouve le mécanisme de self-attention, qui calcule les relations entre chaque token et tous les autres simultanément. Cette opération suit une complexité quadratique O(N²) : pour un contexte de 1 000 tokens, la matrice d’attention traite exactement 1 000 000 de relations par paires. Ajoutez des chunks supplémentaires, augmentez N, et ce mécanisme commence à se saturer. L’attention se dilue. Liu et al. (Stanford/UC Berkeley, 2023) ont formalisé ce phénomène sous le nom de « Lost in the Middle » : les chunks placés en position centrale dans le prompt reçoivent statistiquement moins d’attention que ceux situés aux extrémités. Dans ce cas précis, les passages contenant les informations les plus récentes sur la marque se trouvaient en milieu de contexte. Ils ont été, en pratique, partiellement ignorés.
Le modèle a rejeté le chunk factuel et généré un fait erroné avec un ton pleinement assertif, sans jamais signaler la moindre anomalie.
Le troisième mécanisme est le plus insidieux. Confronté à une contradiction entre un chunk contextuel récent et ses poids pré-entraînés, le modèle opère un arbitrage statistique silencieux. Il ne possède aucune fonction interne pour détecter ni signaler un conflit logique entre sa mémoire paramétrique et sa mémoire contextuelle. Les travaux de Longpre et al. (2021) puis de Xie et al. (2024) documentent ce biais paramétrique : lorsque le savoir pré-entraîné est statistiquement dominant, le modèle l’emporte sur le chunk injecté. La réponse produite incorpore alors le fait obsolète ou incorrect avec une confiance de surface totale. C’est précisément ce qu’on appelle une hallucination de haute fidélité : une erreur formulée avec la même autorité qu’une vérité vérifiée. Pour les marques qui cherchent à contrôler leur représentation dans les réponses génératives, comprendre ce point est la condition préalable à toute action correctrice.
Les trois mécanismes d’échec à retenir, et leurs conséquences pour votre marque
- Premier mécanisme : la dilution attentionnelle par surcharge de contexte. Les recherches de Nelson F. Liu et al. (juillet 2023) ont formalisé le phénomène dit « Lost in the Middle » : les LLM appliquent un biais de position systématique, accordant davantage de poids aux chunks placés en début et en fin de contexte, et ignorant ceux positionnés au centre. Injecter un volume excessif de chunks dans un pipeline RAG ne renforce pas la réponse, cela dilue le budget d’attention physique du modèle. Un chunk critique portant une information exacte, mais positionné défavorablement dans un contexte saturé, sera simplement sous-pondéré et écarté. Pour une marque, cela signifie qu’une politique tarifaire récente peut être ignorée au profit d’une ancienne version, sans aucun signal d’alerte visible dans la réponse finale.
- Deuxième mécanisme : l’absence totale d’arbitrage logique entre sources contradictoires. Les LLM commerciaux reposent sur des calculs de similarité vectorielle, non sur des systèmes de vérification factuelle. Confronté à deux chunks sémantiquement proches mais informationnellement opposés (une ancienne politique versus une nouvelle), le modèle ne tranche pas selon une logique de vérité. Il sélectionne silencieusement l’une des deux options et la restitue avec une confiance apparente, sans signaler le moindre conflit à l’utilisateur. C’est précisément ce mécanisme qui a produit l’erreur documentée dans l’affaire Moffatt v. Air Canada (dossier 2024 BCCRT 149) : le chatbot a synthétisé une réponse factuellement incorrecte sur la politique de remboursement de deuil, incitant le passager Jake Moffatt à acheter des billets plein tarif avec l’assurance d’un remboursement rétroactif qui n’existait pas sous cette forme.
- Troisième mécanisme : la responsabilité légale intégrale de la marque, confirmée par jurisprudence. En février 2024, le Civil Resolution Tribunal de la Colombie-Britannique a condamné Air Canada à verser 812,02 dollars canadiens au passager. L’argument de l’entreprise, selon lequel le chatbot constituait « une entité juridique distincte responsable de ses propres actions », a été rejeté formellement par le membre du tribunal Christopher Rivers, qui l’a qualifié de « soumission remarquable ». La jurisprudence est désormais établie : une marque ne peut se dédouaner via la technologie qu’elle déploie. Elle assume l’intégralité des engagements contractuels générés par ses systèmes d’IA, y compris par hallucination.
- Ce que cela implique concrètement pour tout déploiement RAG en production. Deux impératifs s’imposent. D’abord, une gouvernance documentaire rigoureuse en amont : éliminer toute source contradictoire de la base de données avant l’indexation, non après. Ensuite, contrôler strictement la taille du contexte injecté pour ne pas saturer le budget d’attention du modèle. L’enjeu dépasse la qualité de réponse : c’est la responsabilité financière et réputationnelle de la marque qui est directement exposée à chaque synthèse erronée.
-
 IAdepuis 2 mois
Token IA : calculer et réduire sa consommation étape par étape
-
 IAdepuis 2 mois
GenAI et analyses : ChatGPT, Claude ou Gemini selon le besoin
-
 IAdepuis 2 mois
Quel modèle Claude choisir selon votre profil en 2026
-
 GEOdepuis 1 mois
ChatGPT vs Gemini : deux logiques de citation opposées selon Semrush
-
 IAdepuis 2 mois
GenAI et analyses : ChatGPT, Claude ou Gemini selon le besoin
-
 IAdepuis 2 mois
MCP expliqué aux marketeurs : ce que ça change pour le GEO
-
 SEOdepuis 2 mois
Screaming Frog pour débutants : survivre aux 5 premières minutes
-
 Data & Mesuredepuis 1 mois
Redirections goto Google : un intermédiaire illégal selon le DMA