Contenu & Sémantique
Mise à jour EEAT octobre 2026: Who, How et l’effort éditorial expliqués

Ce que Google a vraiment modifié le 1er octobre 2026
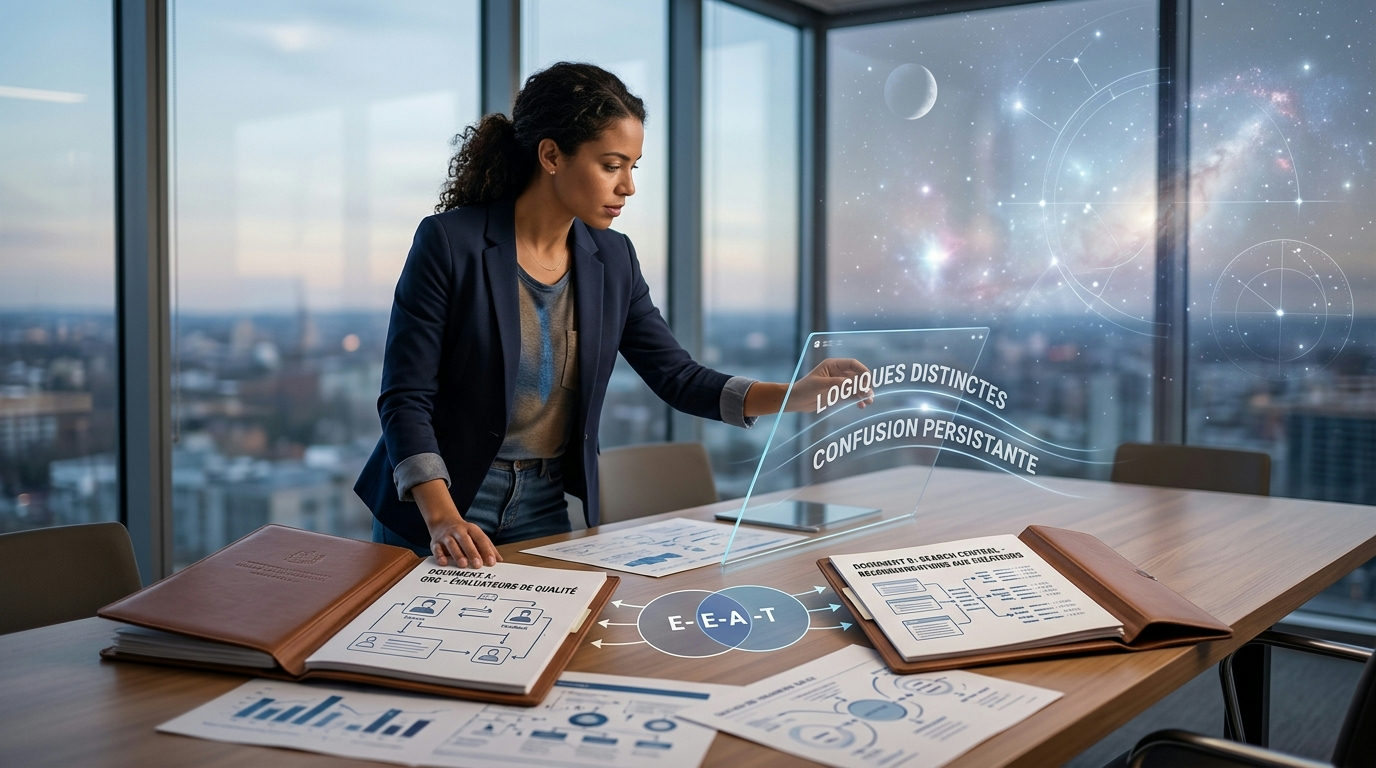
Dans le changelog officiel de Google Search Central, la mise à jour du 1er octobre 2026 est là, noire sur blanc. Pas de Core Update, pas de nouveau pilier E-E-A-T, pas de signal algorithmique inédit. Deux pages de la documentation publique ont été modifiées : « Google Search’s guidance on using generative AI content on your website » et « Creating helpful, reliable, people-first content ». C’est tout.
Ce qui change, c’est la codification. Des exigences d’évaluation jusqu’ici réservées aux instructions internes des Search Quality Raters basculent dans la documentation publique destinée aux éditeurs et aux référenceurs. Google Search Central a lui-même justifié cette synchronisation dans son changelog : aligner les pages d’aide publiques avec les présentations internes et les discours tenus lors des événements développeurs, notamment Search Central Live. La formulation est rare dans sa franchise.
Barry Schwartz, fondateur de Search Engine Roundtable et directeur des actualités chez Search Engine Land, a décortiqué les ajouts textuels dès le 2 octobre. Il a notamment relevé l’emploi du terme « critical » par Google pour qualifier l’obligation de vérification manuelle des faits sur les contenus IA, y compris au niveau des métadonnées, des données structurées et des balises alt. Un mot inhabituellement fort dans ce type de documentation. Search Engine Journal a couvert les répercussions éditoriales via des analyses de Marie Haynes, experte reconnue des Quality Rater Guidelines, et de Matt G. Southern.
Lily Ray, vice-présidente SEO & AI Search chez Amsive, a alerté publiquement sur les risques accrus des publications automatisées non révisées et sur l’alignement imminent entre documentation publique et sanctions algorithmiques. Sa lecture est directe : ce qui était jusqu’ici une grille interne pour prestataires devient un standard auditable.
Ce glissement n’est pas une annonce marketing de Google. C’est une synchronisation entre ce que les évaluateurs humains mesurent depuis des années et ce que les éditeurs peuvent désormais lire noir sur blanc.
Le Spam Update du 24 septembre 2026 reste la dernière mise à jour algorithmique répertoriée à cette période. Aucune position n’a bougé au lendemain du 1er octobre. Traiter cette mise à jour comme anodine sous prétexte qu’elle ne touche pas au code de classement revient à rater exactement ce qui compte.
L’Effort comme attribut formel : le vrai apport de cette mise à jour
La page « Creating helpful, reliable, people-first content » intègre désormais la grille d’évaluation du Contenu Principal, le Main Content, telle qu’elle existait déjà dans les sections 3.2 et 5.2 des Quality Rater Guidelines. Quatre attributs sont officialisés : l’Effort, l’Originalité, le Talent ou savoir-faire, et l’Exactitude. Extraits mot pour mot du référentiel interne que Google remet à ses évaluateurs contractuels, leur présence dans la documentation publique change leur statut. Ce ne sont plus des signaux opaques : ce sont des standards déclarés.
Le terme « Effort » apparaît plus d’une centaine de fois dans les instructions aux Quality Raters, ce qui en faisait déjà un critère cardinal dans l’évaluation humaine de la qualité de page bien avant cette mise à jour. Sa définition formelle dans Search Central est sans ambiguïté : l’Effort mesure le degré de travail humain injecté dans le contenu ou dans les systèmes sous-jacents à sa production. Et Google définit son absence de façon tout aussi précise : la production massive de contenus par intelligence artificielle générative « sans supervision manuelle ni curation » constitue un effort faible ou nul.
Ce qui est nommé change les pratiques. La chaîne « prompt > génération IA > publication » sans intervention humaine est désormais explicitement ciblée dans la documentation publique, pas seulement dans les instructions internes. Google précise en outre que la simple agrégation, la paraphrase de sources existantes ou l’ajout de citations ne constituent pas un effort recevable. La formulation utilisée dans la documentation est directe : « attribution doesn’t replace the need for original effort. » Reformuler cinq sources en les citant, c’est de la compilation. Google le dit maintenant à voix haute.
L’Exactitude mérite une attention particulière pour les thématiques YMYL. Le critère exige la conformité au consensus d’experts, pas seulement l’absence d’erreur grossière. Pour les sujets touchant à la santé, aux finances ou à la sécurité, une page factuellement imprécise, même publiée de bonne foi, risque une évaluation basse qualité. La mise à jour relie aussi explicitement ces attributs à la politique anti-spam sur l’abus de contenu à grande échelle, les sections 4.6.5 et 4.6.6 des QRG : le manque d’effort éditorial est formellement connecté aux mécanismes de détection du spam. Pour tout éditeur qui automatise sa production, la documentation publique devient une feuille de route des vulnérabilités.
Un dernier point opérationnel concerne les métadonnées. L’obligation de vérification manuelle qualifiée de « critical » s’étend aux balises de titre, méta-descriptions, données structurées et textes alternatifs d’images. Les équipes qui ne font vérifier que le corps du texte exposent leur site sur des points que Google juge explicitement prioritaires.
Faux profils d’auteurs : de la mauvaise pratique à la tromperie algorithmique
Le cadre « Who, How, Why » a été introduit par Danny Sullivan et Chris Nelson en février 2023, lors de la publication des premières directives Google sur les contenus générés par IA. Ce n’est pas un apport d’octobre 2026. Ce qui change, c’est ce que Google insère dans la sous-section « Who » : un paragraphe qui qualifie explicitement de tromperie la fabrication de faux profils d’auteurs.
La formulation est sans détour : « Fabricating creator profiles (such as by using AI-generated headshots, made-up names, or false credentials to make content appear as if it was written by human experts) is a form of deception. » Portraits générés par IA, noms inventés, accréditations fictives : tout ce qui simule une expertise humaine pour contourner les critères E-E-A-T tombe sous cette qualification. La pratique existait avant cela, déjà traitée dans la section 4.5.3 des Quality Rater Guidelines sous les pages trompeuses, mais uniquement à destination des évaluateurs humains. Elle est maintenant dans la documentation publique, formulée comme une interdiction formelle à l’attention des créateurs de sites.
Google stipule que « toute forme de tromperie rend une page non fiable tant pour les utilisateurs que pour nos systèmes de qualité automatisés. » Les mots « automated quality systems » élargissent la portée de l’interdiction considérablement. Ce n’est plus seulement un critère coté par un évaluateur humain lors d’un test comparatif interne : c’est un signal explicitement intégré aux algorithmes de classement automatisés, catégorisé comme « a signal of a low-quality page. » La distinction est opérationnelle. Un évaluateur humain qui note une page n’en modifie pas le classement en temps réel. Un signal transmis aux systèmes automatisés, si. Google a toujours pu détecter des patterns de faux profils via ses algorithmes. Ce qu’il fait ici, c’est documenter publiquement que cette détection existe et qu’elle produit une conséquence directe sur la qualité perçue par ses systèmes.
Pour les sites qui ont structuré leur architecture éditoriale autour de biographies générées par IA, de photos de synthèse sur des pages « À propos » ou de noms d’auteurs fictifs, le risque n’est plus théorique. Il est écrit dans la documentation que leurs concurrents lisent aussi.
Comment s’adapter concrètement : priorités éditoriales post-octobre 2026
- Commencer par un audit ciblé : identifier toutes les pages produites via une chaîne « prompt > génération > publication » sans relecture humaine documentée. Ce sont les premières exposées lors d’un Core Update qui applique les quatre attributs formalisés en octobre 2026.
- Pour chaque page auditée, vérifier que l’effort éditorial est traçable : notes de terrain, sources primaires consultées, ajouts factuels qui n’t existent pas dans les textes sources. Si la valeur ajoutée humaine ne peut pas être nommée, la page ne passera pas l’évaluation Effort.
- La relecture ne suffit pas. Google distingue la supervision active, celle qui corrige, restructure, enrichit, de la simple validation passive. Un éditeur qui « vérifie » un texte IA sans y apporter de modification substantielle ne documente pas d’effort réel.
- Auditer les profils auteurs existants en priorité : photo générée par IA, nom d’emprunt, titres non vérifiables. La documentation d’octobre 2026 les classe comme pratiques trompeuses, pas comme signaux négatifs mineurs. Remplacer ou supprimer, pas corriger à moitié.
- Le fait-checking doit couvrir l’intégralité de la page, pas seulement le corps de texte. Les balises de titre, méta-descriptions, attributs `alt` des images et données structurées sont explicitement cités par Google comme périmètre de vérification obligatoire. La plupart des workflows éditoriaux actuels s’arrêtent avant ces éléments.
- Sur les sujets YMYL, l’Exactitude impose la conformité au consensus d’experts, pas l’absence d’erreur flagrante. Une page médicale ou financière factuellement approximative, même publiée de bonne foi, s’expose à une évaluation basse qualité par les raters.
- L’argument « rien n’a changé algorithmiquement » est exact à la date du 1er octobre 2026. Il est aussi non pertinent. Les mises à jour des Quality Rater Guidelines précèdent les Core Updates : les ajouts de janvier 2025 sur l’abus de contenu à grande échelle ont préfiguré le Core Update de mars 2025. Le schéma est documenté.
- Documenter la valeur ajoutée humaine de façon visible : mentions de sources primaires consultées, date de vérification, nom de l’éditeur responsable avec des données structurées `author` conformes aux bonnes pratiques d’audit technique SEO 2026. Google a ajouté la prise en charge des propriétés `author` et `creator` dans les données structurées `VideoObject` dès le 24 septembre 2026, signal clair d’une direction.
- La citation de sources externes ne compense pas l’absence d’originalité. Google le formule sans nuance : l’attribution ne remplace pas l’effort. Agrégation bien sourcée reste agrégation.
- Prioriser les actions par exposition au risque : pages à fort trafic organique sur des thématiques compétitives ou YMYL en premier, pages à faible trafic et fort volume de contenu automatisé en second. L’effort éditorial est une ressource à allouer, pas un standard à appliquer uniformément du jour au lendemain.
Sources et à lire
-
 IAdepuis 2 mois
Token IA : calculer et réduire sa consommation étape par étape
-
 IAdepuis 2 mois
GenAI et analyses : ChatGPT, Claude ou Gemini selon le besoin
-
 IAdepuis 2 mois
Quel modèle Claude choisir selon votre profil en 2026
-
 GEOdepuis 1 mois
ChatGPT vs Gemini : deux logiques de citation opposées selon Semrush
-
 IAdepuis 2 mois
GenAI et analyses : ChatGPT, Claude ou Gemini selon le besoin
-
 IAdepuis 2 mois
MCP expliqué aux marketeurs : ce que ça change pour le GEO
-
 SEOdepuis 2 mois
Screaming Frog pour débutants : survivre aux 5 premières minutes
-
 Data & Mesuredepuis 1 mois
Redirections goto Google : un intermédiaire illégal selon le DMA